经验萃取 Agent 的产品形态:前台一个对话框,后台一整套工作流
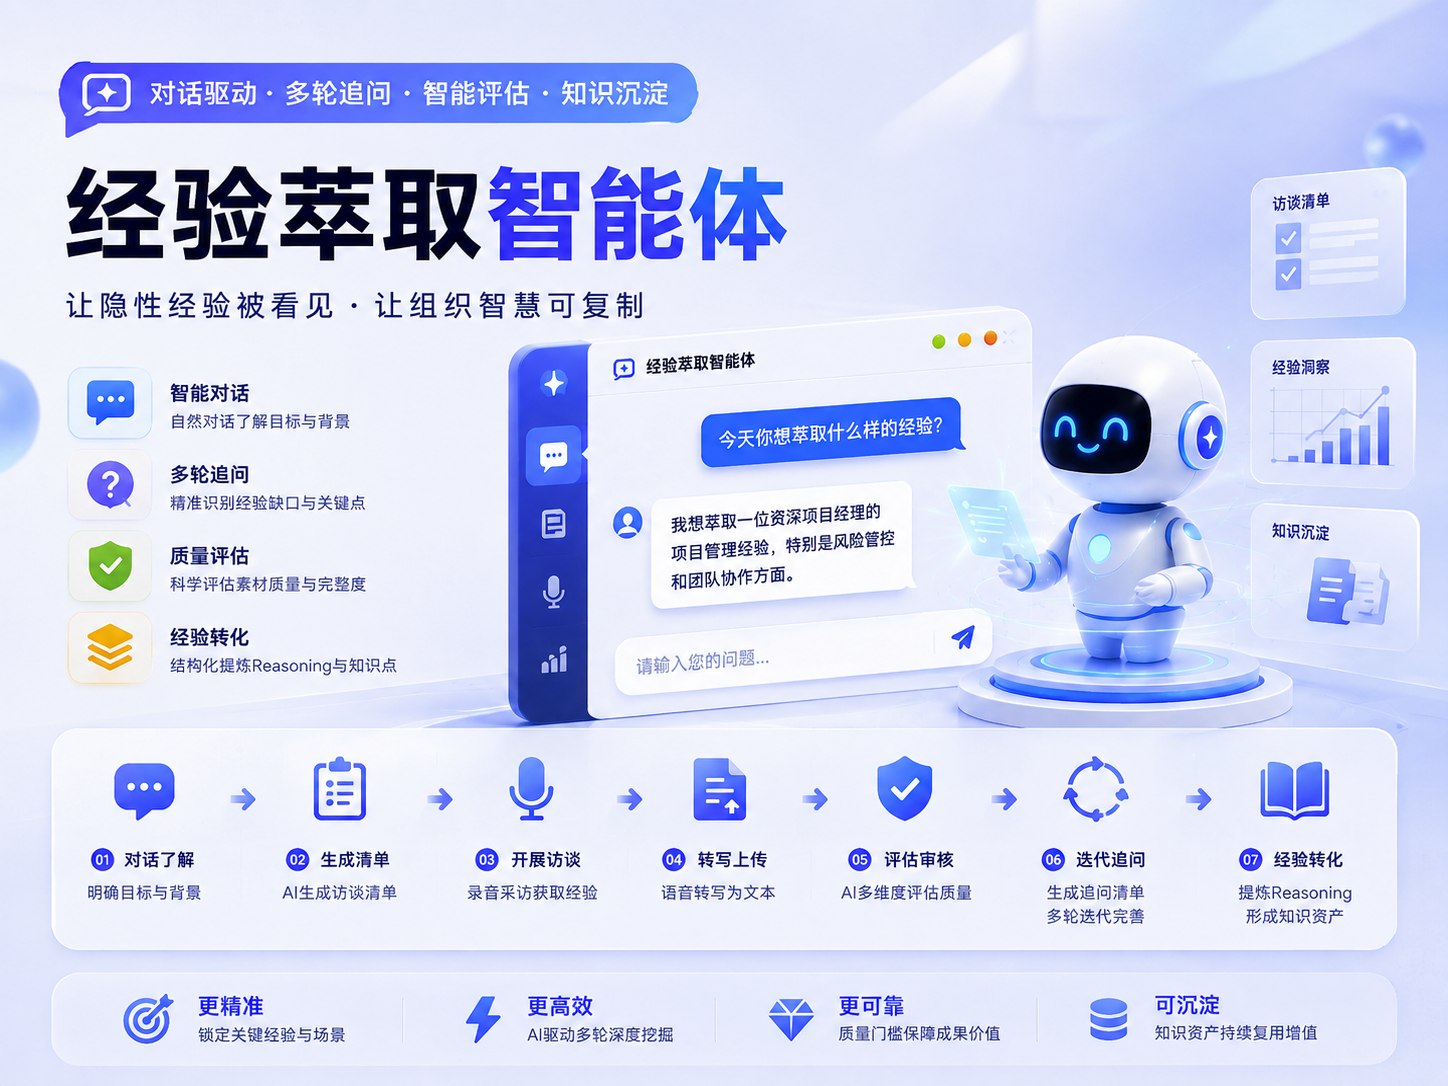
很多组织都在做经验萃取,但大部分工具做的其实只有一件事:把访谈录音变成一份摘要。摘要读起来很顺,可它没法被别人复用——因为素材本身就不够。经验萃取 Agent 不是一个总结访谈记录的 AI 工具,而是一个陪伴萃取师走完全过程的垂直领域工作流 Agent:用户看到的只是一个对话窗口,真正的产品价值在后台的状态机和质量闸门。
产品设计手记 · 垂直领域工作流 Agent
很多组织都在做经验萃取,但大部分工具做的其实只有一件事:把访谈录音变成一份摘要。摘要读起来很顺,可它没法被别人复用——因为素材本身就不够。
一句话说清
经验萃取 Agent 不是一个总结访谈记录的 AI 工具,而是一个陪伴经验萃取师走完「访前准备—深度访谈—质量审核—迭代追问—经验加工—知识资产输出」全过程的垂直领域工作流 Agent。用户看到的只是一个 Chatbot 对话窗口,真正的产品价值在后台的状态机和质量闸门。
它最终呈现给用户的,不应该是一个复杂的软件后台,而应该是一个非常简单的 Chatbot 对话界面——使用体验类似 ChatGPT、Gemini:登录网页以后,看到的是一个干净的一对一对话窗口。但这个 Chatbot 背后运行的并不是普通的问答逻辑,而是一套完整的组织经验萃取工作流。
一、从一句话开始经验萃取
当组织经验萃取师开始一个新的萃取项目时,Agent 首先主动发起对话:
- 今天你想萃取什么经验?
- 你准备萃取谁的经验?他目前是什么岗位或角色?
- 属于什么行业?
- 你最希望从他身上挖出哪方面的经验?
- 这些经验最终准备应用在哪里?
用户不需要填写复杂的项目表单,而是像和一个经验萃取顾问聊天一样,通过几轮自然语言对话完成项目初始化。
Agent 在后台逐渐建立这个项目的基本画像:
萃取对象 + 行业背景 + 岗位角色 + 目标经验 + 典型场景 + 萃取目的 + 预期成果
当信息基本充分以后,Agent 判断:「我已经基本了解这次经验萃取任务,可以开始为你准备第一轮访谈。」
二、Agent 生成第一轮访谈清单
根据前面的对话信息,Agent 自动生成一份针对本次萃取任务的访谈问题清单。用户可以直接在网页中查看、继续与 Agent 讨论和修改、导出 Word 或 PDF,然后拿着问题清单开展线下访谈。
这里 Agent 扮演的是经验萃取师的访谈策划助手。
三、经验萃取师负责真人访谈
组织经验萃取师拿着访谈清单,与经验拥有者进行面对面的深度访谈。访谈可以直接使用手机录音。
录音 → 语音转写 → 访谈逐字稿
然后回到经验萃取 Agent,把访谈逐字稿提交给系统。
四、Agent 不是马上「总结」,而是先做质量评估
这是整个产品非常重要的一点。普通 AI 工具拿到访谈文本以后,第一反应通常是——总结。
经验萃取 Agent 不能这么做。它首先必须回答一个问题:
「这些材料,够不够?」
Agent 对访谈材料进行结构化分析和评分,包括:
- 关键场景有没有讲清楚?事件背景是否充分?
- 当时面对什么问题?做了哪些关键判断?
- 为什么这样判断?采取了什么行动?哪些行动真正影响了结果?
- 遇到了哪些异常情况?如何调整?最终结果是什么?
- 哪些做法可以复制?在什么条件下不能复制?
- 是否存在仍然没有说出来的隐性经验?
最终形成一个经验素材质量评估结果。
五、设置「质量闸门」
系统根据评估结果决定下一步,而不是让用户自己判断。整个工作流在这里出现一个关键的 Quality Gate(质量闸门)。
如果经验素材没有达到设定标准,不允许进入正式经验萃取阶段。Agent 明确告诉萃取师:「目前的访谈素材还不足以形成高质量经验成果。」然后指出:
已经获得了什么 → 还缺什么 → 为什么缺 → 下一轮重点追问什么
随后自动生成《第二轮深度追问清单》。经验萃取师拿着新的清单再次采访,采访回来以后,再把新的访谈材料交给 Agent,Agent 把第一轮、第二轮材料合并分析,再次评分。
如果仍然不合格:继续退回 → 生成第三轮问题 → 再采访 → 再审核,直到通过质量闸门。
六、合格以后,才进入真正的「经验萃取」
当 Agent 判断经验素材已经达到萃取标准,工作流才从「经验获取阶段」进入第二阶段:经验加工与萃取。
这时候 AI 开始对已经验证过的高质量访谈素材进行深度加工。不是简单地把访谈内容压缩成一篇摘要,而是从大量故事、事件和描述中识别真正可以被复用的经验知识:
- 事实(Facts) 发生过什么?当时是什么业务环境?面对什么任务、问题和约束?
- 关键事件(Critical Incidents) 哪些事件真正体现了专家的经验差异?
- 行动(Actions) 专家具体做了什么?
- 判断(Reasoning) 为什么这样做?当时依据什么信号作出判断?
- 规则(Rules) 如果把专家的判断进一步抽象,可以形成哪些可重复使用的经验规则?
- 知识点(Knowledge) 最终有哪些经验可以脱离原来的故事,被其他人学习、调用和复用?
最终形成一条完整的加工链路:
访谈素材 → 事实 → 关键事件 → 行动 → Reasoning → 判断规则 → 知识点 → 可复用经验资产
七、这实际上是一个「对话驱动的经验萃取工作流」
用户从头到尾看到的,始终只是一个 Chatbot。但后台实际上存在一个明确的状态机:
八、用户感受到的是 Chatbot,真正的产品价值是 Agent
所以这个产品不能被定义成「一个帮你总结访谈记录的 AI 工具」。更准确的定义是:
一个陪伴组织经验萃取师完成「访前准备—深度访谈—质量审核—迭代追问—经验加工—知识资产输出」全过程的智能经验萃取 Agent。
前台交互尽可能简单:一个窗口、一段对话、一个任务持续往前推进。真正复杂的东西全部放在后台:
项目状态管理 · 访谈策略 · 素材质量评估 · Quality Gate · 追问生成 · 多轮材料累积 · Reasoning 提取 · 知识结构化 · 成果导出
因此,它表面上像 ChatGPT,但它不是一个「什么都能聊」的通用 Chatbot。它是一个具有明确任务目标、流程状态和质量控制机制的垂直领域工作流 Agent(Vertical Workflow Agent)。
一句话总结
好的经验萃取产品,不是让 AI 更快地写出摘要,而是先替你把关:素材不够,就不许开始萃取。
如果你也在做组织经验萃取,欢迎聊聊你的卡点。
这套产品设计背后的方法论是 FIRE:F 职能与任务、I 关键事件、R 判断逻辑、E 经验本质。文中的质量闸门,本质上就是在检查 R 层的素材够不够。FIRE 经验萃取与课程开发实战营 → 读一个完整的萃取故事 →
交流与咨询:盖尔 13901614328(加微信请备注说明来意)
常见问题
经验萃取 Agent 和普通 AI 总结工具有什么区别?
普通 AI 工具拿到访谈文本后第一反应是总结,产出一份读起来很顺但没法被别人复用的摘要。经验萃取 Agent 会先回答另一个问题:这些材料够不够?它对素材做结构化评分,不达标就不允许进入萃取阶段,而是生成追问清单要求补充访谈。区别不在于总结得快不快,而在于有没有质量把关这一步。
什么是经验萃取中的「质量闸门」(Quality Gate)?
质量闸门是工作流中的一个强制判定环节:系统根据素材评估结果决定能否进入正式萃取,而不是让用户自己判断。不合格时,Agent 会指出已经获得了什么、还缺什么、为什么缺、下一轮重点追问什么,并自动生成下一轮深度追问清单。多轮材料合并后重新评分,直到通过为止。
为什么访谈素材要先评估、再萃取?
因为萃取质量的上限由素材质量决定。如果关键场景没讲清楚、判断依据没问出来、失效条件没覆盖,再强的模型也只能生成一份漂亮但无法复用的摘要。素材不够时正确的做法是回去补访谈,而不是让 AI 用有限信息硬写。
经验加工的完整链路是什么?
访谈素材 → 事实(Facts)→ 关键事件(Critical Incidents)→ 行动(Actions)→ 判断(Reasoning)→ 规则(Rules)→ 知识点(Knowledge)→ 可复用经验资产。核心是从大量故事和描述中,识别出能脱离原始故事、被其他人学习和调用的知识。
什么是垂直领域工作流 Agent(Vertical Workflow Agent)?
指有明确任务目标、流程状态和质量控制机制的 Agent,区别于「什么都能聊」的通用 Chatbot。它的前台交互可以非常简单——一个对话窗口,但后台运行着项目状态管理、策略生成、质量评估、闸门判定、多轮材料累积与成果导出。用户感受到的是 Chatbot,真正的产品价值在 Agent。
