企业上 AI 知识库之前,必须先补这一课
企业把过去十年的制度、会议纪要、培训课件、录音转写和项目报告一股脑放进系统,然后期待 AI 像一位工作二十年的老员工一样回答问题。结果往往是:它说得很完整,也很像那么回事,但关键时刻不敢用。这不是模型不够强,而是企业给它的原料太差。组织经验萃取,是 AI 化的前置工程。
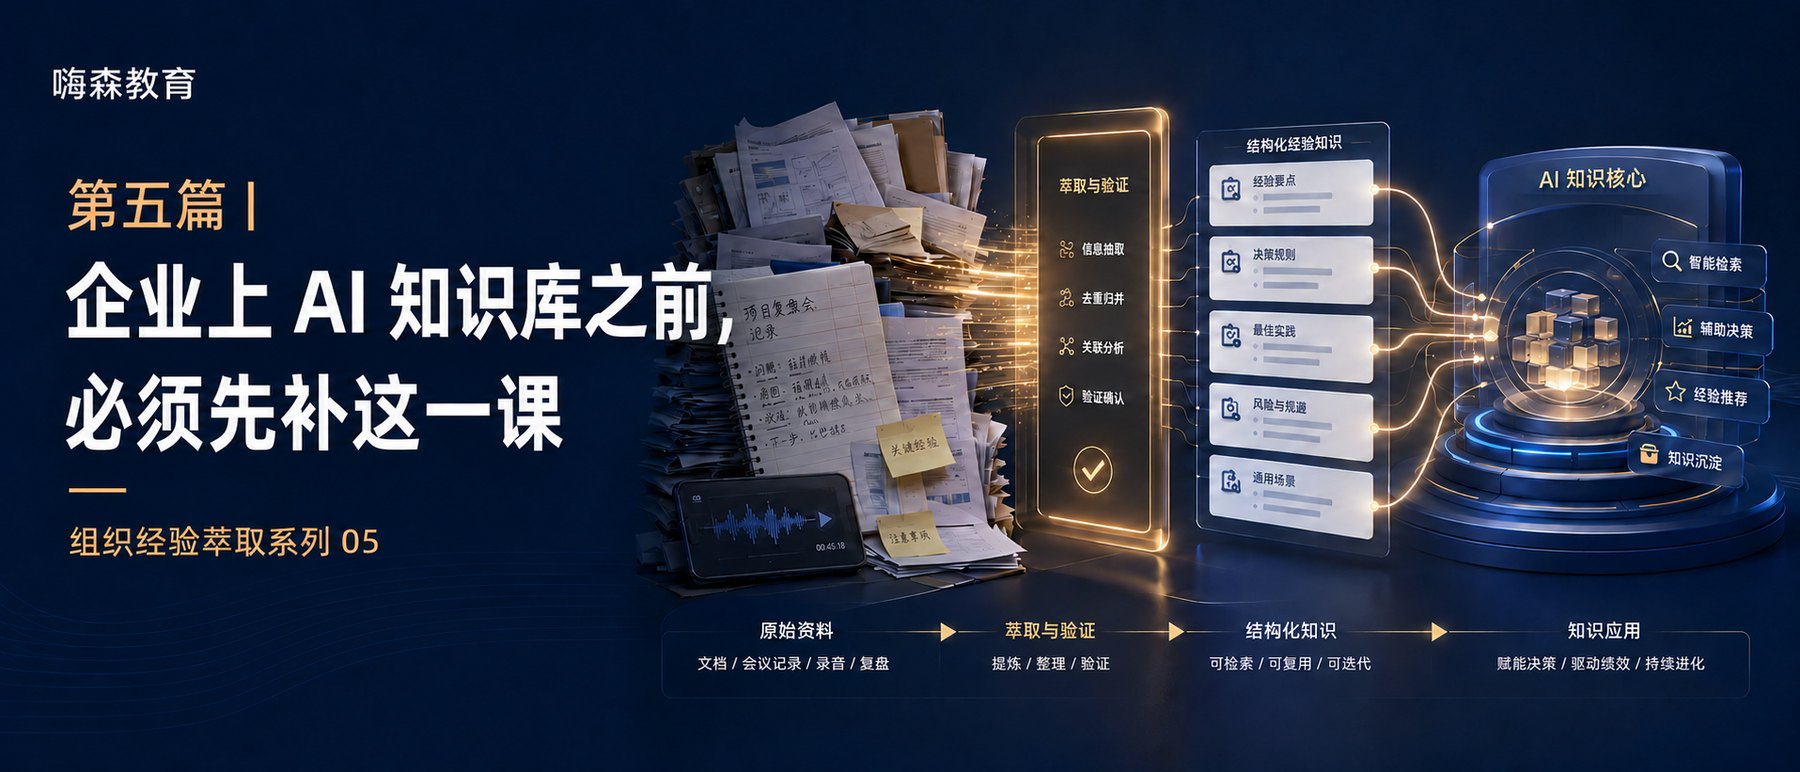
组织经验萃取系列 · 第 5 篇
现在很多企业一谈知识管理,第一反应已经不是建文件夹,而是上 AI 知识库、智能客服、数字员工和 RAG。
方向没有错,但顺序经常错了。
一句话说清
AI 不会自动把散乱文档变成组织智慧。企业把十年的制度、会议纪要、课件、录音转写一股脑放进系统,得到的往往是「说得很完整、关键时刻不敢用」的答案——这不是模型不够强,而是原料太差。正确顺序是:先确定高价值业务场景,再萃取可靠经验,建立审核与更新机制,最后才选择技术承载。
一、文档很多,不等于知识很多
企业资料常见四个问题:
- 同一个问题有多个版本
- 大量内容已经过期
- 制度写了标准流程,却没有例外处理
- 真正有用的判断仍然在专家脑子里
AI 检索到旧版本,不知道哪个有效;遇到相互冲突的文件,也不知道该相信谁。更麻烦的是,它会把残缺的信息组织成流畅答案,让错误显得更可信。
因此,建设 AI 知识库之前,企业必须先回答:哪些业务问题值得让 AI 回答?答案的权威来源是谁?适用范围是什么?出现什么情况必须转交人工?谁负责更新和审核?
二、AI 需要的不是更多文本,而是更清楚的知识结构
一条可以被人和机器共同使用的经验,至少应该写清:
问题 · 情境 · 信号 · 动作 · 判断依据 · 例外 · 失效条件 · 来源 · 最后验证时间
这与传统「写一篇总结」完全不同。总结追求读起来完整,机器可用的知识追求边界清楚、表达一致、能够消歧。
如果企业先写大量故事,再让技术团队拆成知识条目,返工会非常重。更合理的方式,是在经验萃取阶段就考虑后续用途:哪些内容进入 SOP,哪些成为案例,哪些形成问答,哪些成为决策规则,哪些必须保留人工审批。
三、组织经验萃取,是 AI 化的前置工程
AI 可以帮助转写、归类、追问、比较案例和生成初稿,但它不能替企业决定什么是真正有效的经验。这个判断必须来自业务证据、专家复核和实际验证。
换句话说,AI 可以加快萃取,却不能取消萃取。没有经过验证的内容,进入更强大的系统,只会把原来的混乱放大。
嗨森教育正在推动 <b>火龙果组织经验萃取 AI 智能体</b>,目标不是让 AI 替专家编故事,而是帮助企业把萃取流程变得可追踪、可检查、可迭代。
它围绕一条完整链路工作:先澄清萃取任务和对象,再生成访谈框架;对访谈记录进行结构与质量检查,发现素材不足时继续追问;通过真实事件提炼动作、判断和边界;最后根据用途,转化为 SOP、案例、课程、知识卡片或 AI 知识库条目。
这里最关键的不是「自动生成」,而是质量闸门:素材不够,就不应该急着输出;证据不一致,就需要补访和核验;方法没有经过新人试用,就不能直接升格为组织标准。
真实案例读物
《FIRE,那把火》
一部完整呈现组织经验萃取全过程的企业服务商业案例小说。一家生物医药公司的王牌专家即将离职,他能在最难的谈判桌上凭「感觉」翻盘,却说不清自己是怎么做到的。全书 13 章约 3.7 万字,完整走过 F 职能与任务、I 关键事件、R 判断逻辑、E 经验本质四层,也如实写出了专家的抵触、萃取的卡点与最终的验证。
四、别把 AI 项目做成又一次技术采购
企业最容易犯的错误,是先买平台,再到处找内容填进去。最后系统上线了,使用率却很低,因为员工不信任答案,业务也没有把关键问题交给它。
正确顺序应该是:
确定高价值业务场景 → 萃取可靠经验 → 建立审核与更新机制 → 选择合适的技术承载
平台只是容器,可信内容和治理机制才是资产。
AI 知识库不是把旧文件搬进一个新入口。它要求企业第一次认真面对一个老问题:我们真正依赖的经验到底在哪里,它是否说得清、经得住验证、能够被别人使用?
如果这一步没有完成,再强的模型,也只能对着组织的噪音进行高水平发挥。
组织经验萃取系列 · 全 5 篇
- 第 1 篇 你以为老员工离职,带走的只是一个人?
- 第 2 篇 组织经验萃取,最后到底要交付什么?
- 第 3 篇 为什么很多企业做了 SOP,新人还是学不会?
- 第 4 篇 企业大学最缺的,往往不是课程,而是内容生产机制
- 第 5 篇 企业上 AI 知识库之前,必须先补这一课本篇
企业组织经验萃取、关键岗位经验资产化、专家经验成书、互动课程开发,欢迎联系嗨森教育。你攒了这么多年的经验,其实够写一本书了。
火龙果组织经验萃取 AI 智能体 ↗ 专家经验成书服务 → FIRE 实战营 →
咨询:盖尔老师 电话 / 微信 13901614328(请备注来意) 邮箱 support@joyelearn.cn
常见问题
为什么企业上了 AI 知识库,员工还是不敢用它的答案?
因为原料太差,不是模型不够强。企业资料常见四个问题:同一问题有多个版本、大量内容已过期、制度写了标准流程却没有例外处理、真正有用的判断仍在专家脑子里。AI 检索到旧版本不知道哪个有效,遇到冲突文件不知道该信谁,而且会把残缺信息组织成流畅答案,让错误显得更可信。
建设 RAG 知识库之前,企业需要先做什么?
先回答五个问题:哪些业务问题值得让 AI 回答、答案的权威来源是谁、适用范围是什么、出现什么情况必须转交人工、谁负责更新和审核。然后完成知识定标、经验萃取、结构化与验证。正确顺序是先确定高价值业务场景,再萃取可靠经验,建立审核与更新机制,最后才选择技术承载。
机器可用的知识条目应该包含哪些字段?
至少应写清:问题是什么、发生在什么情境、要观察哪些信号、采取什么动作、判断依据是什么、有哪些例外、何时失效、内容来源是谁、最后一次验证是什么时候。这与写一篇总结完全不同——总结追求读起来完整,机器可用的知识追求边界清楚、表达一致、能够消歧。
AI 能不能取代经验萃取?
不能。AI 可以帮助转写、归类、追问、比较案例和生成初稿,但它不能替企业决定什么是真正有效的经验,这个判断必须来自业务证据、专家复核和实际验证。AI 可以加快萃取,却不能取消萃取;没有经过验证的内容进入更强大的系统,只会把原来的混乱放大。
火龙果组织经验萃取 AI 智能体是做什么的?
它是嗨森教育推动的经验萃取工作流智能体,目标不是让 AI 替专家编故事,而是让萃取流程可追踪、可检查、可迭代。工作链路是:先澄清萃取任务和对象并生成访谈框架,对访谈记录做结构与质量检查,素材不足时继续追问,通过真实事件提炼动作、判断和边界,最后按用途转化为 SOP、案例、课程、知识卡片或 AI 知识库条目。关键机制是质量闸门——素材不够就不输出。
